Hoe DeepL omgaat met gestructureerde bestanden
DeepL en Google Translate zijn gebouwd voor één ding: lopende tekst. Ze zijn getraind op miljoenen zinnen uit boeken, artikelen en websites. Ze zijn uitzonderlijk goed in wat ze doen — zolang de invoer gewone taal is.
XML en JSON zijn dat niet. Het zijn gegevensformaten met een eigen grammatica. En die grammatica begrijpen ze niet. Sommige tools proberen dit te omzeilen door eenvoudige bestanden gedeeltelijk te herkennen. Soms werkt dat voor triviale gevallen. Maar zodra een bestand complexer wordt — diepere nesting, attributen met functionele waarden, vakspecifieke terminologie — gaat het onvermijdelijk fout.
Vier manieren waarop het misgaat
1. Attributen en functiewaarden worden meevertaald
In XML bevatten attributen vaak waarden die de applicatie letterlijk verwacht. De vertaaltool ziet ze als tekst — en vertaalt ze mee. Neem dit voorbeeld:
<vraag type="schaal"
       richting="horizontaal">
  Hoe voelt u zich vandaag?
</vraag>
<question type="scale"
          direction="horizontal">
  How do you feel today?
</question>
De zin is correct vertaald. Maar type="schaal" is nu type="scale" — de applicatie verwacht exact de waarde schaal en crasht.
2. JSON-sleutels worden aangepast
In JSON is het onderscheid tussen sleutel en waarde cruciaal. Alleen de waarden mogen vertaald worden — de sleutels zijn de ankerpunten waarop de code vertrouwt.
{
  "vraag": "Hoe voelt u zich?",
  "type": "schaal",
  "min": 1,
  "max": 10
}
{
  "question": "How do you feel?",
  "type": "scale",
  "min": 1,
  "max": 10
}
De code verwijst nog naar "vraag" — maar die sleutel bestaat niet meer. De applicatie geeft lege velden, of een stille fout die pas in productie opduikt.
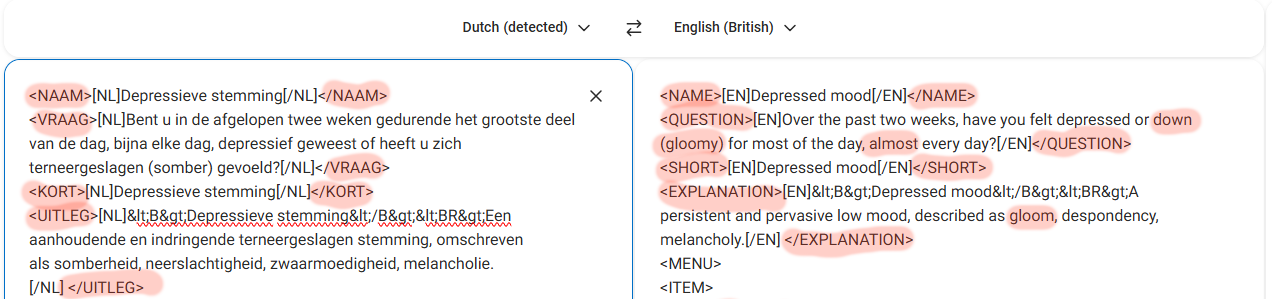
<NAAM> wordt <NAME>, <VRAAG> wordt <QUESTION>. De applicatie herkent deze sleutels niet meer en kan het bestand niet verwerken.3. Hoe de uitvoer er wél uit moet zien
Voor ons gold dat een correct vertaalde structuur de originele sleutels volledig intact laat en de vertaling toevoegt naast de brontekst — in hetzelfde element, gemarkeerd met een taaltag. Zo blijft het bestand voor de applicatie volledig geldig, en zijn beide taalversies in één bestand raadpleegbaar.
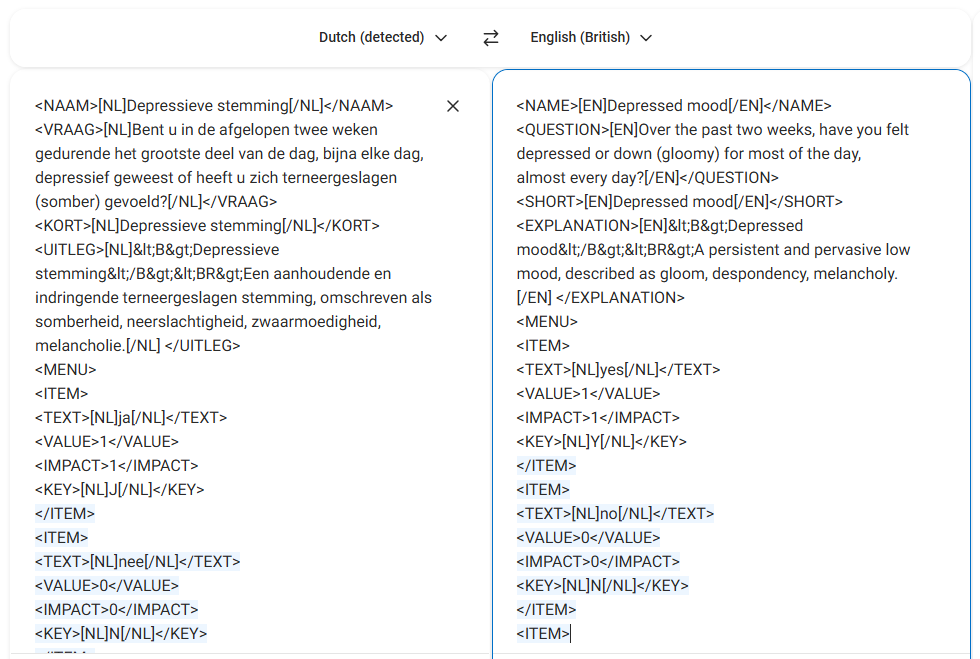
In het voorbeeld hieronder zie je het verschil: DeepL levert een losstaand bestand met vertaalde sleutels, terwijl de gewenste uitvoer de Nederlandse én Engelse inhoud gestructureerd naast elkaar plaatst — met behoud van alle originele tagnamen.
<NAME>[EN]Depressed mood[/EN]</NAME>
<QUESTION>[EN]Over the past two weeks,
  have you felt depressed or
  down (gloomy) for most of
  the day, almost every day?
[/EN]</QUESTION>
<SHORT>[EN]Depressed mood[/EN]</SHORT>
<NAAM>
  [NL]Depressieve stemming[/NL]
  [ENG]Depressed mood[/ENG]
</NAAM>
<VRAAG>
  [NL]Bent u ... somber gevoeld?[/NL]
  [ENG]Have you been depressed
  or felt dejected (sad)...?[/ENG]
</VRAAG>
<KORT>
  [NL]Depressieve stemming[/NL]
  [ENG]Depressed mood[/ENG]
</KORT>
Links: DeepL vertaalt de tagnamen mee (<NAME>, <QUESTION>) en levert alleen de Engelse tekst.
Rechts: de originele structuur blijft intact, NL en ENG staan naast elkaar in hetzelfde element.
Deze meertalige structuur binnen één tag is niet voor elk project de juiste aanpak — maar voor onze situatie was ze onvermijdelijk. De applicatie die de vragenlijst afneemt verwacht de taalvarianten als geneste elementen binnen dezelfde XML-node. Dat is geen ontwerpkeuze die je achteraf kunt aanpassen: de software leest het bestand op precies die manier, of hij leest het niet.
Het fundamentele probleem is dat je DeepL of Google Translate niet kunt instrueren om de vertaling op deze manier te structureren. Die tools kennen één uitvoerformaat: de doeltaal vervangt de brontaal. Ze begrijpen het concept "voeg de vertaling toe náást het origineel, binnen hetzelfde element, gemarkeerd met een taaltag" simpelweg niet. Hoe je het ook formuleert in een prompt of instelling — het lukt niet. De enige manier om dit correct te doen is via een aanpak waarbij de vertaling en de structuur los van elkaar worden behandeld, en daarna weer samengevoegd.
Op dit punt zullen sommige lezers — met name ontwikkelaars — denken: "Maar een generatief AI-model zoals GPT-4 of Claude kan dit toch gewoon met de juiste prompt?" Het is een begrijpelijke gedachte, en bij eenvoudige gevallen lijkt het soms zelfs te werken. Maar voor grote, complexe bestanden brengen large language models hun eigen risico's mee: hallucinaties, stilletjes weggelaten tekstdelen, inconsistente afhandeling van geneste structuren, en uitvoer die er correct uitziet maar het subtiel niet is. Betrouwbare, verifieerbare resultaten krijgen van een LLM op een bestand van 500 items vereist precies het soort zorgvuldige promptsturing, outputvalidatie en vakinhoudelijk toezicht dat de meeste organisaties niet in huis hebben. Dat is precies waar onze ervaring met AI-ondersteund vertalen het verschil maakt: weten wanneer je AI inzet, hoe je het stuurt, en hoe je het resultaat verifieert. Niet als experiment, maar als een beheersbaar en herhaalbaar proces.
4. Terminologie is correct Nederlands, maar verkeerd vakjargon
Dit is de subtielste fout, en daarmee de gevaarlijkste. Een vertaaltool kiest altijd de meest gangbare vertaling. In gewone tekst is dat prima. In een medisch of psychologisch instrument kan het de betekenis volledig ondermijnen.
Een voorbeeld: het woord affect is in de psychologie een vakterm — het verwijst naar de emotionele toestand of stemming van een persoon. Een automatische vertaler ziet het Engelse "affect" en vertaalt dat naar "beïnvloeden" of "aantasten". Begrijpelijk vanuit taalperspectief. Inhoudelijk fout.
Hetzelfde geldt voor juridische termen met meerdere betekenissen, of medische terminologie waarbij één verkeerd woord de interpretatie van een testuitslag verandert.
Waarom nabewerking dit niet oplost
De verleiding is groot om te denken: ik run het door DeepL en controleer het daarna handmatig. Voor een klein, eenvoudig bestand zonder vakjargon is dat soms redelijk. Maar voor complexe bestanden werkt die strategie niet, om twee redenen.
Ten eerste: je weet niet wat je niet weet. Fout vertaalde attribuutwaarden zien er visueel correct uit. Je mist ze in een handmatige review — tenzij je de applicatie integraal test met het vertaalde bestand, wat op zichzelf al een forse tijdsinvestering is.
Ten tweede: nabewerking van een kapot bestand is duurder dan het van tevoren goed doen. Je bent niet meer aan het vertalen — je bent aan het debuggen. De tijdsbesparing van de automatische stap verdampt snel.
Wat wél werkt
De aanpak die wij ontwikkelden, en sindsdien ook toepassen voor andere opdrachtgevers, bestaat uit een paar heldere stappen:
- Analyse vóór de vertaling — welke elementen zijn inhoud, welke zijn structuur? Wat zijn functionele waarden die niet vertaald mogen worden?
- Scheiding van inhoud en structuur — alleen de vertaalbare tekstdelen (strings) worden aangeboden aan het vertaalproces; keys, attributen en markup blijven onaangeroerd.
- Vakinhoudelijke terminologie — bij medische, psychologische of juridische teksten valideert een domeinexpert de terminologie. Dat hoeft niet de vertaler te zijn — maar er moet iemand zijn die dit bewust doet.
- Technische validatie achteraf — het opgeleverde bestand wordt gecontroleerd op geldigheid: structuur intact, alle elementen aanwezig, laadt het foutloos in de applicatie?
Wanneer doe je het zelf, en wanneer niet?
Eerlijk gezegd: voor een klein JSON-bestand met eenvoudige tekst en geen vakjargon is handmatig vertalen met een vertaaltool als hulpmiddel best te doen.
Maar zodra één van de volgende dingen geldt, is het risico groot:
- Het bestand heeft meer dan een paar dozijn "strings"
- De terminologie is domeinspecifiek (medisch, juridisch, psychologisch)
- Het bestand wordt gebruikt in een applicatie of systeem
- Een fout heeft gevolgen voor patiënten, cliënten of juridische geldigheid
Dan is de vraag niet meer of je het kunt doen — maar of je het wilt riskeren.
Heeft u een bestand dat vertaald moet worden?
Vertel ons over uw project en we kijken samen wat de beste aanpak is — vrijblijvend en zonder verplichtingen.
Bespreek uw project